
저는 경영학과에서 컴퓨터공학을 복수전공하고 있기 때문에 이번 학기 '브랜드관리와 CRM'이라는 경영학과의 수업을 들었습니다. CRM은 Customer Relationship Management의 약자로 고객과의 관계를 획득하고, 유지하고 또 강화하는 것입니다. 이러한 과정을 수행하기 위해서는 고객의 니즈(Needs)를 파악하는 것이 중요합니다. 이를 알아야만 고객 맞춤화 혹은 개인화를 할 수 있고, 이를 통해 또 고객의 이탈을 막고 customer loyalty를 높일 수 있습니다. 저는 리뷰 데이터에 고객들이 자주 언급하는 부분들이 니즈와 밀접한 관계가 있을 것이라고 생각합니다. 그리고 그 중 부정적인 리뷰에서는 현재 상품의 부족한 부분 혹은 고객이 만족하지 못하는 부분이 반영되어 있을 것이라고 생각합니다.따라서 고객의 니즈를 파악하기 위해 고객이 리뷰에서 어떠한 토픽(니즈)에 대해 이야기하는 지를 확인해보고자 합니다.
https://nijianmo.github.io/amazon/
데이터는 위의 링크에 있는 'Amazon Review Data' 중 'Amazon Fashion reviews' 데이터를 사용하였습니다.
아래는 사용한 feature에 대한 설명입니다.
asin - 제품 ID
vote - 리뷰가 도움이 되었는지 투표(ex. 좋아요)
style - 제품에 대한 메타 데이터(색상, 사이즈 등)
reviewText - 리뷰 데이터
overall - 제품 점수
summary - 리뷰 데이터 요약
아래는 데이터를 사용할 시, 인용을 요청한 논문입니다.
Justifying recommendations using distantly-labeled reviews and fined-grained aspects
Jianmo Ni, Jiacheng Li, Julian McAuley
Empirical Methods in Natural Language Processing (EMNLP), 2019
방법은 자연어 처리 기술 중 토픽 모델링 기법을 사용해보고자 합니다. 토픽 모델링 기법은 통계적 기법 중 하나로 문서 집합에서 토픽이라는 주제를 찾기 위한 방법입니다. 이번 프로젝트에서는 리뷰 하나가 하나의 문서라고 가정하고 리뷰들의 집합에서 숨겨진 주제를 뽑아내는 것이 목표입니다.
그리고 전체 리뷰 데이터와 부정적인 리뷰 데이터에 대해 똑같은 과정을 거쳐 전체 리뷰 데이터에서는 고객의 니즈를 파악하고, 부정적인 리뷰 데이터에서는 그 중 부족한 부분에 대해서 파악하고자 합니다.
알고리즘은 대표적인 알고리즘 중 하나인 LDA를 사용할 예정입니다. LDA는 Latent Dirichlet Allocation의 약자로 문서들이 토픽의 확률 분포로 구성되고, 토픽들은 단어들의 확률 분포로 구성되 있다고 가정하는 모델입니다. 수행 과정은 hyperparameter로 토픽의 개수 k를 지정하게 되면 모든 단어에 하나의 토픽이 부여됩니다. 이 후 같은 문서 내 다른 단어들의 토픽 비율과 각 단어들의 토픽 비율을 살펴보면서 단어에 할당되었던 토픽을 재할당하게 되고 수렴할(더 이상 변화가 없을) 때까지 이를 반복합니다.
알고리즘은 아래의 링크와 영상을 보고 공부하였습니다.
딥 러닝을 이용한 자연어 처리 입문
2) 잠재 디리클레 할당(Latent Dirichlet Allocation, LDA)
https://wikidocs.net/30708
고려대학교 산업경영공학부 DSBA 연구실
07-2: Topic Modeling Part 2 (LDA Document generation process)
https://youtu.be/WR2On5QAqJQ
tool은 jupyter notebook을 사용하였고, 각 과정을 하나의 .ipynb 파일로 진행하였습니다.
모든 리뷰 데이터를 대상으로 한 파일에는 파일명 뒤에 _all을 덧붙였습니다.
두 데이터 모두 다른 사람에게 공감을 하나 이상 받아야 신뢰할만한 리뷰라고 판단하여 'vote' > 0 의 데이터만 사용하였고, 부정적 리뷰의 경우 'rating' 3 미만인 데이터를 사용하였습니다.

성능을 높이기 위하여 다음과 같은 순서로 텍스트 전처리도 진행하였습니다
소문자 변환 - 영어 외 문자 제거 - 토큰화 - 품사 태깅 - 표제어 추출 - 불용어 제거
이후 LDA를 진행하였을 때, 동사와 이를 수식하는 부사에서는 의미있는 정보를 찾기 힘들다고 판단하여 표제어 추출 과정에서 형용사와 명사 외에는 제거하였습니다.
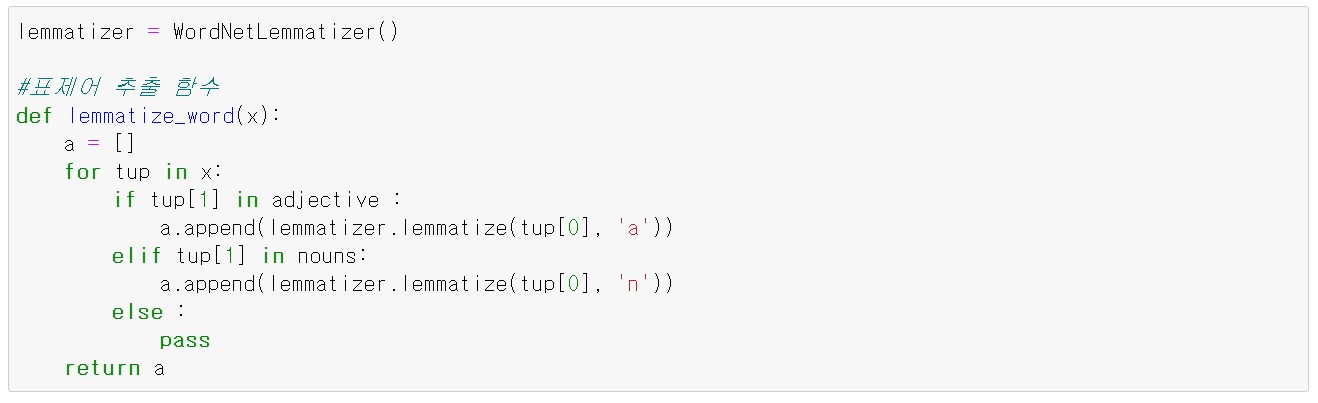
LDA는 gensim이라는 open source library를 사용하여 구현하였습니다. 라이센스 또한 gensim과 동일하게 설정하였습니다. LDA를 수행하기 위해서는 hyperparameter인 토픽 수를 정해야 하는데, 이 때는 perplexity와 coherence를 참고하였습니다. perplexity는 혼잡도로 값이 낮을수록 좋고 coherence는 응집도로 값이 높을수록 좋습니다. 물론 두 지표 모두 절대적인 지표는 아니고 사용자의 재량에 따라 토픽 수를 선택하면 되지만 비지도 학습이기 때문에 판단하기에 어려움이 있어 두 지표를 기준으로 선정하였습니다.
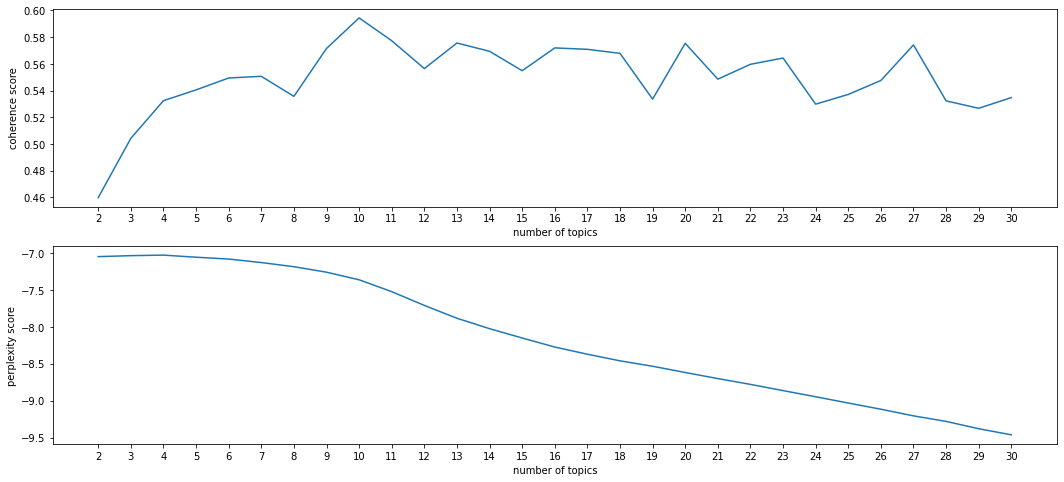
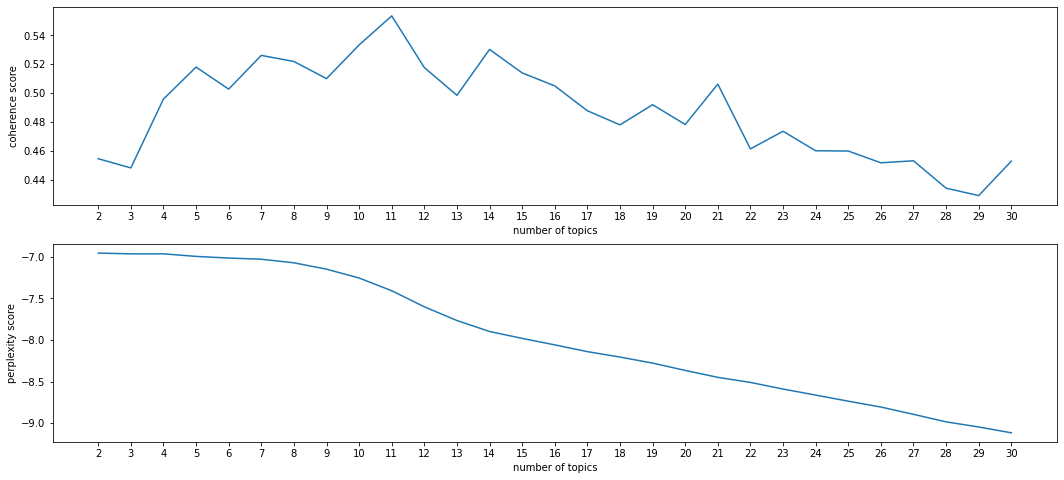 위 그림은 모든 리뷰 데이터, 아래 그림은 부정적인 리뷰 데이터의 topic 별 coherence / perplexity 그래프입니다.
결론적으로 부정 리뷰는 토픽 수를 14개, 모든 리뷰는 토픽 수를 20개로 선정하였습니다.
그리고 토픽 별 토픽 구성 비율이 높은 단어 20개를 출력하였습니다.
아래 두 개의 사진은 토픽 별 토픽에서 비중을 크게 차지하는 20개의 단어를 출력한 결과입니다.
엑셀에서의 행은 토픽을 의미하고, 열은 특정 단어의 해당 토픽의 비중에 대한 순서를 의미합니다.
예를 들어, (0,0)에 'beautiful'이라는 단어가 있다면 'beautiful'이 0번 토픽에서 가장 큰 비중을 차지하는 단어라는 의미입니다.
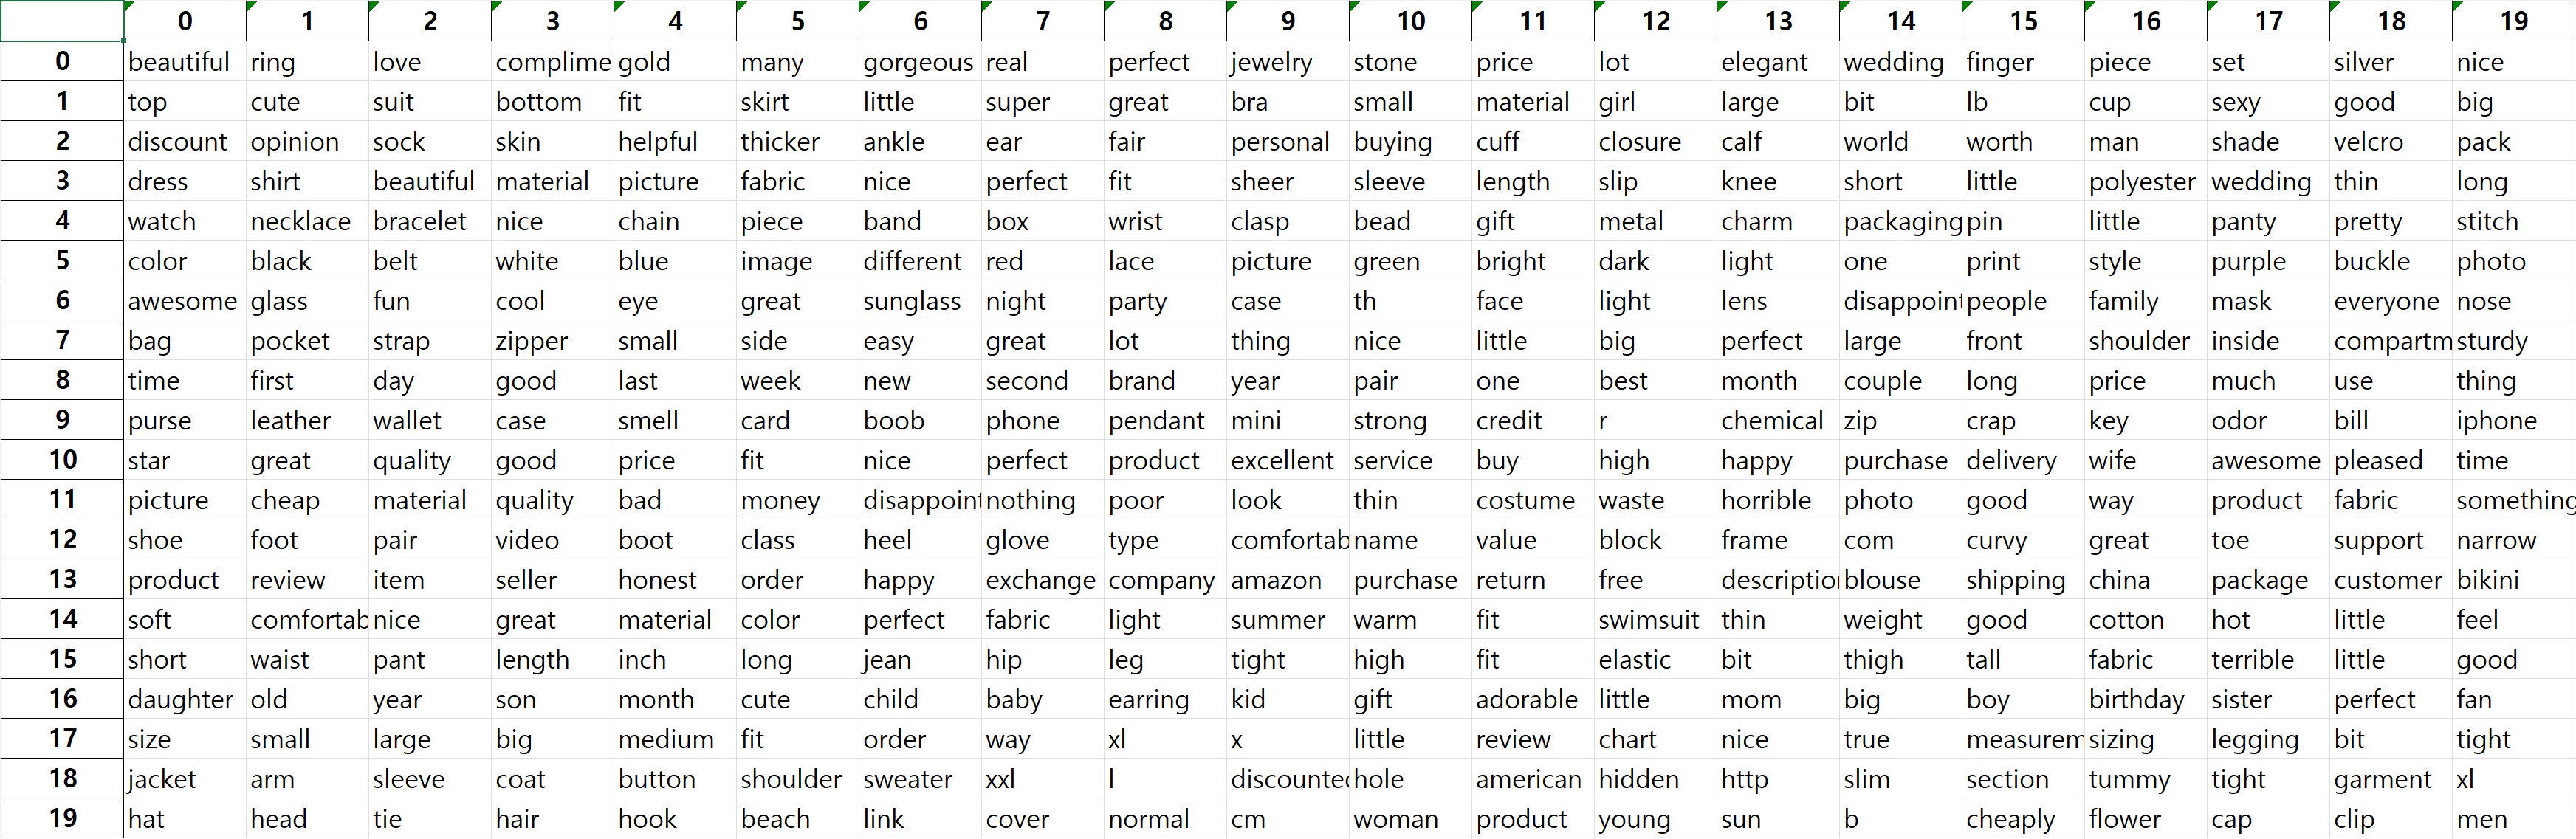 위의 사진은 모든 리뷰를 대상으로 한 결과입니다.
생각보다 불필요한 명사가 너무 많지만 14번 토픽과 같이 부드럽고 편안한 재질, 9번 토픽에서는 purse와 wallet에서는 가죽의 냄새, 17번 토픽에서는 사이즈가 작거나 크거나에 관한 사이즈에 대한 문제, 18번 토픽에서는 자켓과 코트의 팔 기장 혹은 어깨 부분과 같이 고객들이 자주 리뷰를 하는 포인트들을 찾을 수 있었습니다.
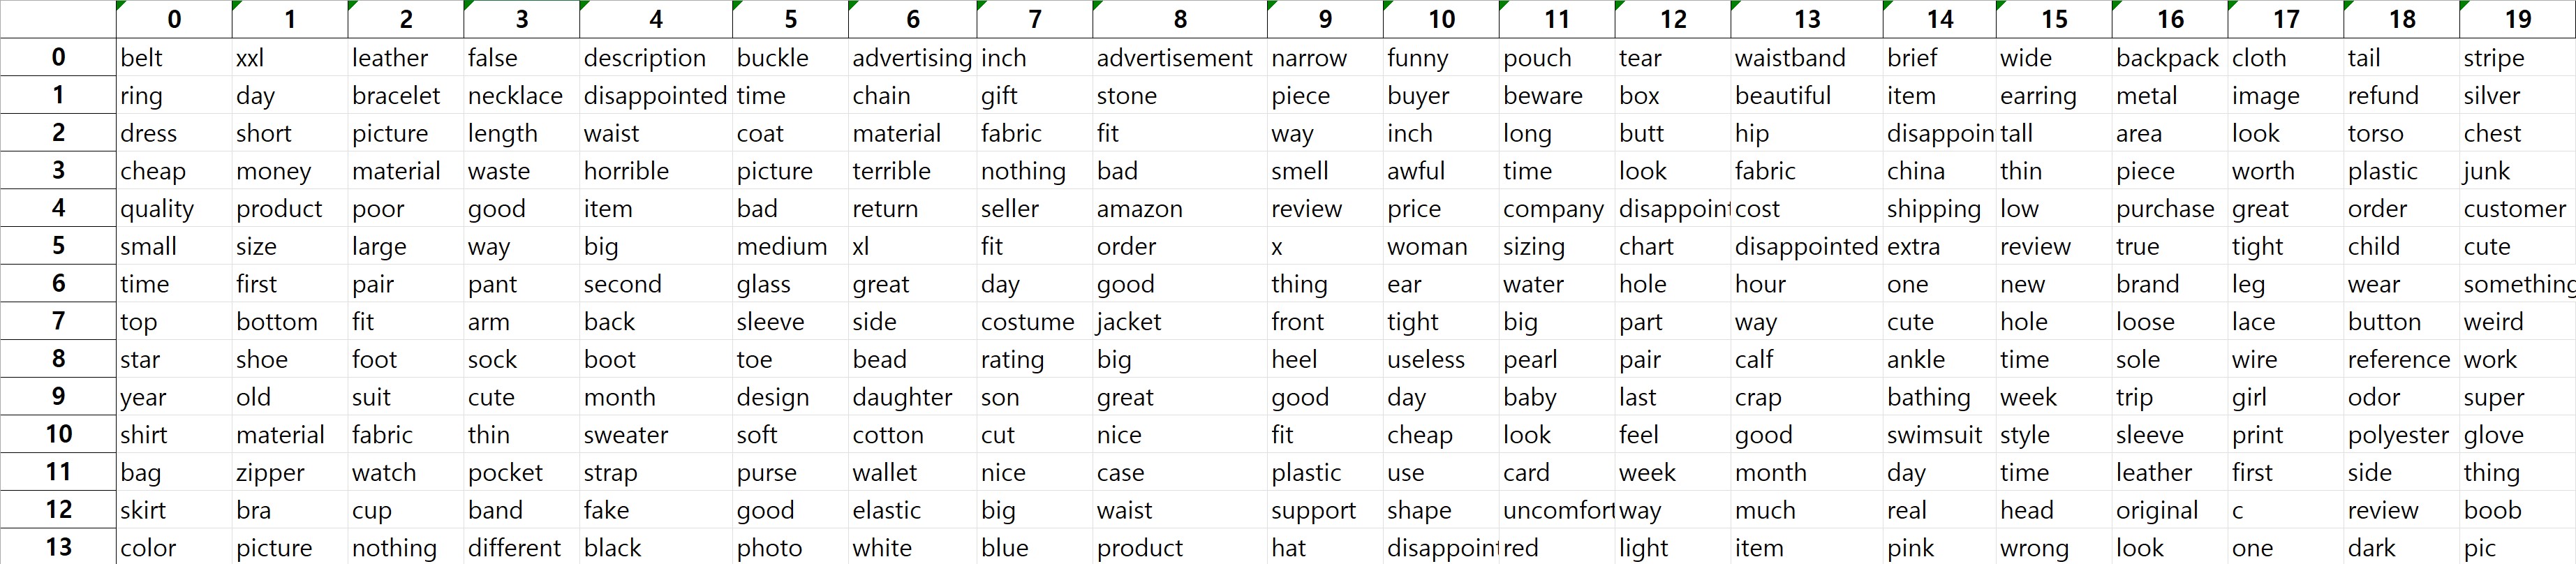 위의 사진은 부정적인 리뷰를 대상으로 한 결과입니다.
1번 토픽의 경우 벨트 버클의 가짜 가죽 문제인 것으로 예상되고, 4번 토픽의 경우 품질이 너무 좋지 않다는 것으로 해석할 수 있고, 13번 토픽의 경우 색상이 사진과 너무 다르다는 것으로 해석할 수 있습니다.
예상과는 다르게 생각보다는 결과가 좋지 않았습니다. 그 이유는 생각보다 토픽 별 비중이 높은 단어에 ring, belt, dress 같은 품목들이 많았습니다. 그리고 부정적인 리뷰에 생각보다 긍정적일 수 있는 단어들이 많았는데 아마 그 이유는 보통 부정적인 리뷰를 작성할 때, 특정 부분은 긍정적이었지만 부정적인 부분이 아쉬웠다는 식의 리뷰가 많기 때문인 것 같습니다. 따라서 다음에는 불용어를 더 추가하고, 사이에 문장의 부정과 긍정을 판단하는 감성 분석의 과정을 추가하여 부정적인 리뷰 혹은 긍정적인 리뷰들만을 대상으로 하면 조금 더 의미 있는 결과가 나올 것 같습니다.