
- Naufaldy
- Fadilah
- Yudha
- Bunga
- Fauzan
- Dicky
- Nabil


Face tracking atau pelacakan wajah adalah teknologi yang dapat mendeteksi dan mengikuti posisi wajah seseorang secara real time melalui kamera.
Teknologi ini banyak digunakan dalam:
- Sistem keamanan otomatis
- Absensi berbasi wajah
- Efek kamera
Salah satu cara untuk membuat face tracking adalah dengan algoritma Cascade Classifier dari Library OpenCV di Python.
OpenCV (Open Source Computer Vision Library) adalah library open source untuk pengolahan gambar atau video, serta pengembangan sistem visi komputer (computer vision) dan pembelajaran mesin (machine learning).
Casecade Classifier adalah algoritma deteksi objek yang dikembangkan oleh Viola dan Jones pada tahun 2001. Disebut Cascade karena prosesnya bertingkat, mulai dari penyaringan sederhana sampai kompleks.
Algoritma dari cascade classifier berjalan mengunakan library OpenCV yang melalui proses 4 tahap yaitu :
- Selecting Haar-like features :

Merupakan proses memilih pola-pola sederhana (fitur Haar) yang digunakan untuk mengenali ciri khas suatu objek, seperti perbedaan terang dan gelap pada wajah. Fitur ini membantu mendeteksi bagian-bagian penting dari objek, seperti mata, hidung, atau tepi wajah
Tentu. Rumus tersebut adalah inti dari cara kerja Haar-like Features, yang merupakan fondasi dari algoritma deteksi wajah Viola-Jones.
Secara sederhana, rumus ini bekerja dengan membandingkan total kecerahan (intensitas) piksel di area hitam dengan total kecerahan piksel di area putih pada sebuah templat fitur.
Berikut ini adalah keterangan dari setiap komponen pada rumus:
-
$f(x, y)$ : Ini adalah nilai akhir atau skor dari fitur tersebut ketika ditempatkan pada posisi (x, y) di gambar. Hasilnya adalah satu angka tunggal. -
$\sum$ (Sigma) : Ini adalah simbol matematika untuk iterasi. Artinya summation atau "jumlahkan semua..." -
$i \in R_b$ : p berarti pixel intensity (nilai kecerahan piksel, biasanya 0 untuk hitam pekat dan 255 untuk putih pekat). Subskrip b berarti black (hitam). Jadi, Σ$i \in R_b$ berarti "total jumlah nilai kecerahan dari semua piksel yang berada di bawah area hitam pada templat." -
$i \in R_w$ : p berarti pixel intensity. Subskrip w berarti white (putih). Jadi, Σ$i \in R_w$ berarti "total jumlah nilai kecerahan dari semua piksel yang berada di bawah area putih pada templat." -
$p(i)$ Intensitas (nilai kecerahan) piksel pada indeks$i$ .
- Creating an integral image :
Tahap ini membuat representasi gambar baru di mana setiap titik menyimpan jumlah total nilai piksel dari sudut kiri atas hingga titik tersebut. Teknik ini digunakan untuk mempercepat perhitungan fitur Haar di berbagai area gambar.
Gambar integral memberikan cara cepat dan sederhana untuk menghitung nilai fitur Haar-like feature. Hal ini dilakukan dengan memanfaatkan Summed Area Table. Nilai untuk lokasi (x, y) pada gambar integral adalah jumlah piksel di atas dan di kiri (x, y) pada gambar asli ditambah dirinya sendiri. Misalnya, untuk menghitung (2,2) = 16 = 5+2+3+6
Setelah membangun gambar integral, gambar tersebut digunakan untuk menghitunng diinginkan.
Untuk mendapatkan jumlah persegi panjang biru, cukup tambahkan nilai hijau dan kurangi nilai merah pada gambar integral. 1+21–11–3 = 8.

- Running AdaBoost training : Pada tahap ini, digunakan algoritma pembelajaran AdaBoost untuk memilih dan menggabungkan fitur-fitur terbaik (yang paling mampu membedakan antara objek dan bukan objek) menjadi sebuah model klasifikasi yang kuat. Algoritma ini juga memberi bobot lebih pada kesalahan, agar model terus membaik pada setiap iterasi.

- Creating classifier cascades : Proses menyusun beberapa classifier secara bertahap, dari yang paling sederhana hingga yang lebih kompleks. Setiap tahap bertugas menyaring area gambar jika sebuah area gagal pada tahap awal, maka langsung dianggap bukan objek dan tidak dilanjutkan ke tahap berikutnya. Pendekatan ini membuat proses deteksi menjadi jauh lebih cepat dan efisien.
- Gambar wajah dibaca frame per frame dari kamera.
- Algoritma memeriksa tiap bagian gambar menggunakan fitur Haar-Like.
- Tiap tahap menyaring bagian yang tidak mirip wajah.
- Bagian yang lolos dari semua tahap dianggap wajah.
- Cepat, karena tidak perlu memproses seluruh piksel.
- Sudah tersedia dalam bentuk model XML yang bisa langsung di gunakan, contohnya “haarcascade_frontalfcae_default.xml”.
- Proses cepat dan ringan untuk real time.
- Mudah diimplementasikan.
- Tidak butuh data training tambahan.
- Kurang akurat pada pencahayan rendah.
- Tidak bisa mengenali wajah individu (hanya mendeteksi wajah).
- Sulit mendeteksi wajah dari samping tau miring.
Face tracking menggunakan Cascade Classifier dari OpenCV itu salah satu cara untuk membuat komputer mendeteksi wajah secara realtime. Walau hasilnya masih banyak kekurangannya, tetapi ini adalah salah satu metode pembelajaran yang mudah untuk mengenali wajah secara realtime. Dengan pehamanan dasar ini bisa dikembangkan lagi untuk membuat sistem keamanan ataupun robot yang bergerak jika mendeteksi wajah.


Deep Learning (DL) merupakan sub-disiplin dari Machine Learning (ML) yang didasarkan pada Arsitektur Jaringan Saraf Tiruan (Artificial Neural Networks - ANN) dengan kedalaman substansial (banyak lapisan). Prinsip intinya adalah mempelajari representasi data secara hierarkis.
Berbeda dengan metode ML tradisional yang seringkali memerlukan rekayasa fitur (feature engineering) secara manual, DL mengotomatiskan proses ini. Jaringan yang "dalam" (deep) terdiri dari beberapa lapisan tersembunyi (hidden layers) yang tersusun. Lapisan awal mempelajari fitur-fitur level rendah (misalnya, deteksi tepi atau tekstur dalam gambar), dan seiring data mengalir lebih dalam ke jaringan, lapisan-lapisan berikutnya mengabstraksi dan mengombinasikan fitur-fitur ini untuk membentuk konsep yang lebih kompleks (misalnya, bentuk objek atau wajah).
Formulasi Matematis Dasar (Perceptron & Aktivasi)
Unit dasar dari ANN adalah perceptron atau neuron. Operasi matematis untuk satu neuron dapat direpresentasikan sebagai berikut:
Di mana:
-
$x$ adalah vektor input. -
$w$ adalah vektor bobot (weights) yang merepresentasikan kekuatan koneksi. -
$b$ adalah bias, yang memungkinkan pergeseran fungsi aktivasi. -
$z$ adalah output linier (logit). -
$\phi(z)$ adalah fungsi aktivasi non-linier (seperti Sigmoid, Tanh, atau yang paling umum saat ini, ReLU).
Fungsi ReLU (Rectified Linear Unit) didefinisikan sebagai:
Non-linearitas ini krusial; tanpanya, jaringan yang dalam hanya akan menjadi ekuivalen dengan satu lapisan linier. Proses pembelajaran (training) dilakukan dengan mengoptimalkan w dan b menggunakan algoritma seperti Backpropagation dan Gradient Descent untuk meminimalkan sebuah Fungsi Kerugian (Loss Function).

Convolutional Neural Networks (CNN) adalah kelas khusus dari arsitektur Deep Learning yang dirancang secara eksplisit untuk memproses data dengan topologi grid, seperti citra digital (data 2D) atau sinyal (data 1D). Keunggulannya terletak pada dua konsep utama: parameter sharing dan sparse connectivity (invariansi translasi).
Arsitektur CNN standar terdiri dari tiga jenis lapisan utama:
Lapisan ini adalah inti dari CNN. Alih-alih menghubungkan setiap neuron input ke setiap neuron output (seperti pada lapisan fully connected), lapisan konvolusi menerapkan sebuah filter (atau kernel) pada area lokal dari input (disebut receptive field).
Operasi konvolusi 2D diskrit didefinisikan sebagai:
Di mana:
- I adalah matriks citra input.
- K adalah kernel (filter) yang dipelajari.
- S adalah output yang dihasilkan, yang disebut Feature Map.
Kernel ini "digeser" (convolved) melintasi seluruh citra, mendeteksi fitur spesifik (misalnya, tepi vertikal). Karena kernel yang sama (K) digunakan di seluruh citra (parameter sharing), jumlah parameter yang harus dipelajari berkurang drastis, dan model menjadi invarian terhadap translasi (fitur yang sama dapat dideteksi di mana saja dalam gambar).
Lapisan ini bertujuan untuk melakukan down-sampling atau reduksi dimensionalitas spasial dari feature map. Tujuannya adalah untuk mengurangi kompleksitas komputasi dan memberikan tingkat invariansi yang lebih tinggi terhadap pergeseran kecil.
Jenis yang paling umum adalah Max Pooling, yang mengambil nilai maksimum dari sebuah area lokal (misal, jendela 2×2):
Di mana S adalah feature map, k adalah ukuran pool, dan s adalah stride.
Setelah beberapa lapisan konvolusi dan pooling mengekstraksi fitur-fitur hierarkis, data diratakan (flattened) menjadi vektor 1D dan dimasukkan ke lapisan FC (jaringan saraf biasa) untuk tugas akhir, seperti klasifikasi.
Face Recognition (FR) adalah aplikasi visi komputer yang bertujuan untuk mengidentifikasi atau memverifikasi identitas individu dari citra digital. Tantangan utama dalam FR adalah varians intra-kelas yang tinggi (satu orang dapat terlihat sangat berbeda karena pose, pencahayaan, ekspresi, dan usia) dan varians inter-kelas yang rendah (dua orang yang berbeda dapat terlihat mirip).

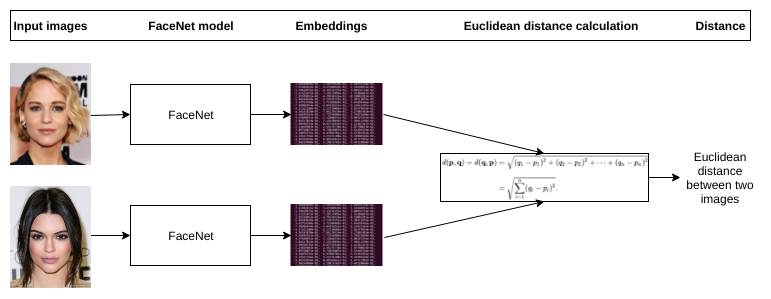
FaceNet adalah sebuah sistem FR berbasis Deep Learning yang diperkenalkan oleh Google (Schroff, Kalenichenko, Philbin, 2015). Inovasi utamanya adalah tidak melatih jaringan untuk mengklasifikasi wajah. Sebaliknya, FaceNet melatih CNN untuk mempelajari pemetaan (mapping) dari citra wajah x ke sebuah vektor fitur kompak dalam ruang Euklides 128-dimensi, yang disebut embedding.
Tujuannya adalah agar di dalam ruang embedding 128-D ini, jarak antar vektor secara langsung mengkorelasikan kesamaan wajah:
Jarak Kecil: Wajah dari individu yang sama akan memiliki embedding yang berdekatan (jarak Euklides kuadrat kecil).
Jarak Besar: Wajah dari individu yang berbeda akan memiliki embedding yang berjauhan (jarak Euklides kuadrat besar).
Arsitektur dan Fungsi Triplet Loss
Untuk mencapai tujuan ini, FaceNet memperkenalkan sebuah fungsi kerugian baru yang disebut Triplet Loss. Alih-alih menggunakan satu gambar, proses pelatihan menggunakan tiga gambar sekaligus (sebuah triplet):
Anchor (xia): Citra referensi dari seorang individu.
Positive (xip): Citra lain dari individu yang sama dengan Anchor.
Negative (xin): Citra dari individu yang berbeda.
Tujuan dari Triplet Loss adalah untuk "menarik" embedding Anchor dan Positive agar berdekatan, sambil "mendorong" embedding Anchor dan Negative agar berjauhan.
Secara formal, kita ingin memenuhi kondisi berikut:
Di mana:
Fungsi Triplet Loss (L) kemudian diformulasikan untuk meminimalkan pelanggaran terhadap kondisi ini:
$L = \sum_{i}^{N} \max \left( |f(x_i^a) - f(x_i^p)|_2^2 - |f(x_i^a) - f(x_i^n)|_2^2 + \alpha, \ 0 \right)$
Di mana [z]+=max(z,0). Loss hanya akan bernilai positif (ada "hukuman") jika pasangan negatif lebih dekat ke anchor daripada pasangan positif (setelah memperhitungkan margin α).
Penggunaan (Inference)
Setelah jaringan (seringkali arsitektur Inception atau GoogLeNet) dilatih menggunakan Triplet Loss, bagian loss function dibuang. Model f(x) yang sudah terlatih kini menjadi generator embedding yang kuat.
Registrasi: Wajah baru (misal, S dari Signature) dimasukkan ke FaceNet, dan embedding f(S)∈R128 disimpan di database. Verifikasi (1:1): Untuk memverifikasi wajah V (dari Value), kita hitung f(V). Kemudian, kita hitung jarak Euklides kuadrat:
Jika d(S,V)<τ (di mana τ adalah threshold yang ditentukan, misal 0.9), maka wajah diverifikasi sebagai orang yang sama.
Identifikasi (1:N): Diberikan wajah V, hitung f(V) dan bandingkan jaraknya dengan semua N embedding di database. Identitas ditentukan oleh embedding dengan jarak terdekat (Nearest Neighbor):
Dengan pendekatan metric learning ini, FaceNet memecahkan masalah skalabilitas. Wajah baru dapat ditambahkan ke database kapan saja hanya dengan menghitung dan menyimpan embedding 128-D mereka, tanpa perlu melatih ulang seluruh model.
- https://www.cv-foundation.org/openaccess/content_cvpr_2015/papers/Schroff_FaceNet_A_Unified_2015_CVPR_paper.pdf
- https://www.sciencedirect.com/science/article/pii/S2468227623004611
make sure you have install python version 3.10 and above
you can clone this repo with git bash or git desktop to getting this source code project into your local machine
git clone https://github.com/Dickybulin26/Algoritma_1C_OpenCV_CascadeClassifire.git
after you clone the project, open the folder project with code editor such as VSCode, Jupyterlab or PyCharm.
make virtual env is better for you to isolate the dependencies for your project than using global env. it will easy to setup and manage the dependecies that you need for the project.
make virtual env:
pip install virtualenvpython -m venv .venvsource env/Scripts/activate.bat // in CMDorsource env/Scripts/Activate.ps1 //In Powershel
pip install requirements.txt
now you can run the program